個人情報保護法は機能しているのか? 大手企業から相次ぐ情報流出、そして盗まれた個人情報は何に使われるのか

大手企業から次々と流出する個人情報

最近、個人情報流出のニュースを見ない日がないほど、大手企業による情報流出の発表が相次いでいる。

GMO、ローソン、焼肉きんぐ、ブックオフ、ソースネクスト、カプコン、無印良品、ノジマ、NTTドコモなど、その名前を聞けば誰もが知っている企業ばかりだ。

そして、メール配信サービスへの不正アクセスによって、数千万件もの情報が流出し、多くの企業に被害が広がっている。

ここで、私は二つの疑問を感じている。

一つ目は、個人情報保護法という法律が存在するにもかかわらず、なぜこれほど簡単に大量の個人情報が流出してしまうのか、ということ。

二つ目は、そもそも個人情報が盗まれたとして、その情報だけで犯罪者には何ができるのか、ということだ。

もちろん、個人情報が盗まれることを容認しているわけではない。

ただ、情報流出というニュースを一括りにするのではなく、何が漏れたのか、それがどれほど危険なのか、法律はどこまで被害者を守ってくれるのかを冷静に考えたい。

まずは、実際に何が起きているのかを振り返ってみる。


2026年10月5日以降に発表された主な情報流出事案

以下は、2026年10月5日から11月8日までに確認できた、大手企業・著名サービスを中心とする情報流出事案の一覧である。

表の見方

  • 「確認」:情報の外部流出が公表資料などで確認されている事案
  • 「可能性」:流出のおそれがあるもの、または影響範囲の調査が続いている事案
  • 「関連」:外部委託先などへの攻撃が原因となった事案

件数は各社の公表値や続報に基づく概数であり、流出確認済みの人数とは限らない。複数企業に同じ情報が含まれる場合もあるため、合計して被害者数を算出することはできない。

10月5日〜20日

公表日企業・サービス公表規模状況
10/5GMOリサーチ&AI(infoQ)約89.4万件確認
10/5物語コーポレーション(焼肉きんぐ)約1,079万件確認
10/5大和証券約11万人関連・可能性
10/5セイコーマート約57.5万件続報
10/5大起水産約17.5万人可能性
10/6ミスターマックス約173.5万人確認
10/6シチズン時計約10万人関連・可能性
10/6旭化成セラピューティクス関連最大約51.4万人関連・可能性
10/6スカラコミュニケーションズ最大約71.3万件可能性
10/8ローソン約215.5万件確認
10/8第一興商約872.4万件関連・可能性
10/8ユーザベース(NewsPicks)最大約32.3万件可能性
10/8オリックス生命約2.7万件関連・可能性
10/9ブックオフグループ最大約643万件一部確認
10/9アドベンチャー(skyticket)約1,464万件一部確認
10/9ディップ(バイトル)最大約388.6万件可能性
10/9JR東日本延べ約206万件可能性
10/9JR九州約130万件関連・可能性
10/9手間いらず約445万件調査・続報
10/11アルカディア(防災メール)最大約313万件可能性
10/13ライドオンエクスプレス(銀のさら)最大約650万件可能性
10/15バーガーキング約1,118万件確認
10/15ソースネクスト約2,252万件確認
10/16日本経済新聞社約183万件確認
10/16ファンケル・アテニア合計約83.5万件確認
10/16Eストアー(ショップサーブ)約2,335万件続報
10/17上新電機(Joshin)最大約623万件可能性
10/19阪急阪神百貨店約126万件確認
10/19ニフティ最大約54.3万件可能性
10/19ユミルリンク(Cuenote FC)延べ約5,163万件可能性・続報
10/20トラストバンク(ふるさとチョイス)約445.4万件確認

10月21日〜31日

公表日企業・サービス公表規模状況
10/21リクルート(カーセンサー)最大約371万件可能性
10/21GMOインターネット(デスクトップクラウド)影響可能性のあるサーバー26,739件別件・不正アクセス
10/22カプコン(CAPCOM ID)約1,177万件確認
10/23リンツ&シュプルングリージャパン約314.7万件関連・確認
10/23トレジャー・ファクトリー約74.6万件確認
10/23アンドエスティHD顧客約250万件可能性
10/24ピッコマ約100.2万件関連・確認
10/27ソニーネットワークコミュニケーションズ約258.5万件確認
10/28花キューピット約423.8万件確認
10/28ソニー生命保険約38.5万件確認
10/28日本航空・日本トランスオーシャン航空約9.2万件関連・可能性
10/29アララ(アララメッセージ)約8,133万件確認・可能性混在
10/30全日本空輸(ANA)約3.8万人関連・確認
10/30良品計画(MUJIアプリ等)最大約2,726万件可能性
10/30松屋フーズ約237.7万件確認
10/30ワールド(RAGTAG関連)延べ約120万件可能性
10/30ヤクルト本社約4万件確認
10/30日本交通約29万人可能性
10/31クラブツーリズム約432万件可能性

※ユミルリンクの約5,163万件は10月26日の続報、アララの約8,133万件は11月6日の続報による規模。

※GMOインターネットのサーバー件数は個人情報の人数・件数ではなく、不正アクセスの影響範囲を示す数値である。

※良品計画では11月4日の続報で、当初発表された項目以外の情報や、一部のカード情報への不正アクセスの可能性も明らかになっている。

11月1日〜8日

公表日企業・サービス公表規模状況
11/2ノジマ約700万件確認
11/2アイスタイル(@cosme)約300万人確認
11/2サントリーホールディングス約10万人確認
11/2ビックカメラ・コジマ・ソフマップ合計約1,490万件関連・可能性
11/2プレステージ・インターナショナル関連最大約550万件確認・調査中
11/2北陸電力約55万件関連・確認
11/2TKC最大約223.1万件関連・確認
11/2ウィルズ(ネットマイル)最大約549万件可能性
11/3アソビュー約1,582.1万件関連・確認
11/3大阪ガス(FitDish)約3.4万件関連・確認
11/3小田急トラベル約6.3万件関連・確認
11/3丸井グループ最大約9,086件関連・確認
11/4モスフードサービス約751.7万件関連・確認
11/4プレナス(ほっともっと)最大約700万件確認
11/4ワークマン最大約145万件関連・確認
11/4IIJ(IIJmio)約98.3万件関連・確認
11/4ダスキン約65.8万件関連・確認
11/4住友不動産約20.5万件関連・確認
11/4松竹マルチプレックスシアターズ約332万件関連・確認
11/5GMOメイクショップ約1,260万件関連・確認
11/5カカクコム(価格.com・食べログ等)約570万件関連・確認
11/5NTTドコモ最大約29.5万件確認・続報
11/5SMBCコンシューマーファイナンス最大約32万人確認
11/5三井住友銀行約22.7万件関連・確認
11/5三井不動産約13.3万件関連・確認
11/5NTTタウンページ約14.2万件関連・確認
11/5コナカ約43.4万件確認
11/5松井証券最大約83万件関連・確認
11/5損害保険ジャパン約6.5万件関連・可能性
11/5GMOペイメントサービス最大約10.7万件関連・確認
11/6ロート製薬約279.8万人確認
11/6チームスピリット約2.9万件確認
11/6日本ネットワークセキュリティ協会(JNSA)最大約1.5万件可能性
11/7シグナルトーク(Maru-Jan)約185.6万人確認

この一覧だけでも、実に多くの企業が関係している。

ただし、これがすべて独立したサイバー攻撃だったわけではない。

アララ、ユミルリンク、フューチャーショップなどの外部サービスへの攻撃によって、契約企業の顧客情報がまとめて流出した事案が含まれている。

同じ情報が複数社の発表に含まれる可能性も高いため、上記の数字を合計して「日本人の何億人分が流出した」と表現するのは間違いだ。

しかし、これほど幅広い業種で顧客情報が外部に持ち出されているという事実は、重く受け止める必要があるだろう。


個人情報保護法があるのに、なぜ情報流出が止まらないのか?

日本には「個人情報の保護に関する法律」、いわゆる個人情報保護法がある。

この法律があることは、多くの人が知っているはずだ。

企業側も個人情報を収集するときには、利用目的を説明し、プライバシーポリシーを提示している。

では、企業が収集した個人情報を守れず、外部に流出させてしまった場合はどうなるのだろうか。

実は、個人情報保護法は、個人情報の流出を一件も発生させてはいけないという結果を保証する法律ではない。

重要な条文として、次のものがある。

  • 第23条:安全管理措置
    企業は、個人データの漏えいなどを防ぐため、必要かつ適切な安全管理措置を講じなければならない。
  • 第25条:委託先の監督
    個人データを外部に委託する場合、委託先に対しても必要かつ適切な監督を行わなければならない。
  • 第26条:漏えい等の報告・本人通知
    一定の重大な漏えい等が起きた場合、個人情報保護委員会への報告と本人への通知が必要となる。

つまり、法律は企業に情報を適切に管理する義務を課している。

しかし、実際に情報が流出したからといって、それだけで直ちに法律違反が確定するわけではない。

必要かつ適切な安全管理措置が講じられていたか、委託先への監督が適切だったか、といった事情によって判断される。

ここに私は、大きな疑問を感じる。

大量の個人情報を預かっている企業が、何百万件もの情報を流出させても、法律上の責任が直ちに明らかになるわけではない。

もちろん、外部からの高度な攻撃を完全に防ぐことは不可能だ。

だからといって、セキュリティ対策の不備があった場合まで、単に「サイバー攻撃の被害者だから仕方ない」で済ませてよいのだろうか。

実は、情報流出そのものに自動的な高額罰金があるわけではない

個人情報保護法に違反した企業に対しては、個人情報保護委員会による調査、指導、勧告、命令などが行われる。

命令に違反すると、刑事罰の対象となり得る。

しかし、個人情報が100万件漏れたら罰金いくら、1,000万件ならいくら、という制度ではない。

これは意外に思う人も多いのではないだろうか。

企業が適切な安全管理を怠った場合には行政上の責任が問われ得るし、被害者に損害が発生すれば民事上の損害賠償責任が認められる可能性もある。

それでも、利用者からすれば、個人情報が流出した後に企業のお詫び文を読むだけで、実際にどのような責任が問われたのか分からないことも少なくない。

私は、法律を厳罰化すればすべて解決するとは思わない。

過度な罰則は、企業が事故の発見や公表をためらう原因にもなり得るからだ。

むしろ重要なのは、どのような不備があったのか、再発防止策が本当に実施されたのか、それを利用者が確認できる仕組みではないだろうか。

国も「基本的な対策が不十分」と指摘している

実際、2026年11月5日には、国家サイバー統括室が相次ぐ情報流出について注意喚起を発表した。

そこでは、基本的なセキュリティ対策が不十分だったと考えられる事案が複数確認されたとされている。

具体的には、次のような問題だ。

  • Webサイトやモバイルアプリの開発時のセキュリティ対策不足
  • Webシステムの設定不備
  • サポートが終了したソフトウェアの使用
  • 既知の脆弱性が修正されていないソフトウェアの継続利用

これは、システム開発者として見過ごせない問題だ。

Webサイトの見た目だけが最新になっていても、バックエンドで古いフレームワークやライブラリが稼働し続けている可能性がある。

例えば、サポートの終了したフレームワークや、脆弱性が見つかっているにもかかわらず修正されていないライブラリなどだ。

私は、これをすべての被害企業に当てはめるつもりはない。各事件の侵入経路は異なり、原因がまだ分かっていない事案もある。

しかし、国が基本的な対策不足を複数確認している以上、単に攻撃者の技術が高度化しただけでは説明できない問題がある。

システムを作って終わりではなく、長期間にわたって安全に運用するための費用と人員を確保しているか。

そのことこそ、もっと問われるべきではないだろうか。


そもそも個人情報を盗んで、何ができるのか?

ここからが、私が特に考えたい問題だ。

企業から情報が流出したと報道されると、多くの人は不安を感じる。

しかし、個人情報といっても、その内容はさまざまだ。

メールアドレスだけが漏れた場合と、クレジットカード番号やパスワードまで盗まれた場合では、危険性がまったく異なる。

ここを区別しないまま、単に「1,000万人の個人情報が流出した」と報じるだけでは、実際の危険性を判断できない。

① メールアドレスだけが流出した場合

メールアドレスが知られただけで、相手が自分の銀行口座からお金を引き出せるわけではない。

通常、メールアドレスだけでは、Webサービスにログインすることもできない。

ただし、迷惑メールやフィッシング詐欺の標的にはなる。

例えば、ある企業の会員メールアドレスが大量に流出した場合、その企業を装ったメールが届く可能性がある。

しかも、攻撃者は、その人が実際にそのサービスを利用していると知っている。

「お客様の会員情報に問題が発生しました」

「不正アクセス対策のため、パスワードを変更してください」

こうしたメールが、本物のサービスの利用者に送られれば、無関係な相手に送るよりも信用されやすいだろう。

実際、アララの事件では、メール配信基盤を不正利用して、クレジットカード会社を装った不審メールが最大約713万通送信された。

つまり、メールアドレスの流出は、直接お金を盗めることを意味しないが、その後の詐欺の足掛かりになる。

② 氏名、住所、電話番号、生年月日が流出した場合

これはどうだろうか。

氏名や住所、電話番号は、日常生活の中で他人に伝えることも珍しくない。

企業の代表者であれば、公開されている情報もある。

こうした情報が盗まれたとしても、それだけで銀行口座からお金を引き出したり、他人になりすまして簡単に口座を開設したりできるわけではない。

金融機関や通信会社では、本人確認書類や追加の認証などが求められるからだ。

しかし、危険がないわけではない。

氏名、住所、生年月日、電話番号などを組み合わせると、本人を装った問い合わせや、電話による詐欺、本人確認が弱いサービスでのなりすましなどに利用される可能性がある。

また、盗まれた情報が別の流出データと突き合わされれば、その人の生活や利用サービスについて、より詳しい情報が得られる可能性もある。

一つひとつの情報だけでは大きな危険がなくても、組み合わせによって危険性が増す。

ここが個人情報流出の難しいところだ。

③ IDとパスワードが流出した場合

これは危険性が大きく変わる。

IDとパスワードがそろっていれば、不正ログインを試みることができる。

さらに問題となるのが、パスワードの使い回しだ。

例えば、ゲームサイトから盗まれたパスワードが、メールサービスやECサイトでも使用されていれば、ほかのサービスまで不正ログインされる可能性がある。

また、ハッシュ化されたパスワードも、必ずしも安全とはいえない。

適切なアルゴリズムやソルトなどで保護されていれば復元は困難になるが、保存方式やパスワードの強度によっては、元のパスワードを推測される危険が残る。

実際、2026年10月に公表されたskyticketの情報流出では、約413万件分のハッシュ化されたログインパスワードが含まれていた。

そして11月7日、オンライン麻雀「Maru-Jan」でも約185.6万人分のメールアドレスとパスワードの流出が発表された。

このような事案は、メールアドレスだけの流出とは明確に区別して考える必要がある。

④ クレジットカード情報が流出した場合

これは直接的な金銭被害につながる危険がある。

カード番号、有効期限、セキュリティコードなどの組み合わせによっては、第三者が不正な決済を試みることができる。

ただし、クレジットカード決済には本人認証などの追加対策があり、すべてのカード情報流出がそのまま不正利用につながるわけではない。

それでも、氏名やメールアドレスだけの流出と比較すれば、注意すべき危険は大きい。

2026年11月6日、ロート製薬は約279.8万人分の顧客情報の流出を公表した。

その中には、約9,715人分のクレジットカード番号と有効期限が含まれる通話音声も存在していた。

このような情報まで流出した場合には、カード会社との連携や、不正利用の確認など、より具体的な対応が必要になる。

⑤ 運転免許証や本人確認書類が流出した場合

これも危険性が高い。

本人確認書類の画像には、氏名、住所、生年月日、顔写真、書類番号などが含まれる。

それだけであらゆる本人確認を突破できるわけではないが、なりすましや偽造書類の作成に悪用される可能性がある。

また、顔写真や本人確認書類の情報は、パスワードのように簡単に変更できるものではない。

今回の情報流出では、Joshinで運転免許証画像やマイナンバーカード関連情報の流出の可能性が公表されている。

このような事件を、メールアドレスだけが漏れた事件と同じ重さで報じるべきではないと思う。

流出した情報による危険性の違い

流出情報主な悪用リスクそれだけでできること
メールアドレス迷惑メール、フィッシング通常は直接ログイン不可
氏名・住所なりすまし、詐欺の勧誘金融取引には通常追加確認が必要
電話番号SMS詐欺、電話によるなりすましそれだけでSMS認証を突破できるわけではない
生年月日他の情報との照合、弱い本人確認の突破単独での悪用範囲は限定的
ID・パスワード不正ログイン、アカウント乗っ取り認証条件次第で直接悪用可能
クレジットカード情報不正決済追加認証の有無などによる
本人確認書類の画像身元のなりすまし、書類悪用サービス側の本人確認方式による
病歴・診療情報等プライバシー侵害、差別や恐喝への悪用金銭被害がなくても深刻な権利侵害になり得る

ここで言いたいのは、個人情報の流出を軽く考えるべきだということではない。

何が盗まれたのかによって、危険性は違う。だからこそ、流出件数だけでなく、情報の種類や具体的な被害まで説明するべきではないか、ということだ。


「二次被害は確認されていない」という発表をどう読むべきか

個人情報流出のニュースでは、企業が「現時点で二次被害は確認されていない」と説明することが多い。

この言葉は、嘘ではないかもしれない。

しかし、それは「今後も悪用されない」という意味ではない。

流出した情報がどこへ渡ったのか、誰が保有しているのか、その後どのような目的で使われるのか、企業側が完全に把握することは難しい。

一方で、漏えいした情報が実際に悪用された証拠がないなら、すべての利用者に深刻な被害が発生するかのように語るのも正確ではない。

重要なのは、次の三つを分けて考えることだ。

  1. 個人情報が外部に持ち出された事実
  2. その情報を悪用できる技術的・制度的な可能性
  3. 実際に不正利用や金銭的被害が発生した事実

この三つは同じではない。

「流出」と「被害」は、関連していても同義ではないのだ。


個人情報が漏れた人は、企業に何を請求できるのか?

もう一つ気になるのが、被害者に対する補償である。

例えば、自分の氏名、住所、電話番号、生年月日が企業から流出したとして、その企業に何らかの補償を求めることはできるのだろうか。

結論として、損害賠償を請求できる可能性はある。

しかし、情報が流出したというだけで、自動的に一定額の補償金が支払われるわけではない。

損害賠償には、プライバシー侵害の程度や損害の有無、企業側の責任などが関係する。

過去のベネッセの個人情報流出事件では、裁判でプライバシー侵害が認められ、差戻し後の控訴審で一人当たり1,000円の慰謝料が認められた例がある。

また、別の裁判例では、数千円から数万円の慰謝料が認められたものもある。

これは、金銭的な二次被害が発生していなくても、情報が本人の意思に反して外部へ流出したこと自体が、法的に保護されるプライバシーを侵害し得ることを示している。

一方で、補償額は個別事情によって大きく異なる。

企業が自主的に見舞金を支払う場合もあるが、すべての企業が同じ対応をするわけではない。

私は、ここにも考えるべき問題があると思う。

何百万人もの個人情報が流出した場合、個々の利用者が裁判で責任を追及することは現実的なのだろうか。

個人で訴訟を起こすための時間や費用を考えれば、諦める人がほとんどではないだろうか。

本当に利用者の権利を守るというのであれば、事故発生後の説明責任や被害回復の仕組みについても、議論を深めるべきだと思う。


本当に必要なのは、個人情報を集めすぎないことではないか

私がシステム開発の観点から特に重要だと考えるのは、そもそも企業がどれほどの個人情報を収集し、どこに保存しているのかという問題だ。

例えば、単にメールマガジンを配信するだけなら、必ずしも氏名、住所、生年月日、電話番号まで必要とは限らない。

メールアドレスだけで済むのであれば、それ以外の情報を外部サービスへ渡さない設計も可能だ。

企業が大量の個人情報を保有していれば、それだけ流出したときの影響も大きくなる。

さらに、そのデータを複数の外部サービスに複製していれば、攻撃される可能性のある場所も増える。

今回のアララの事案は、その問題を浮き彫りにした。

一つのメール配信サービスへの攻撃が、多数の企業の顧客情報へと波及したのである。

クラウドサービスやSaaSを利用すること自体が悪いわけではない。

むしろ、それらを活用することで、企業は短期間に高度なサービスを開発できる。

ただし、外部サービスを利用するなら、委託先の安全管理だけでなく、委託する情報を必要最小限にすることが重要だ。

盗まれた情報を取り戻すことは難しい。しかし、最初から保存していない情報は盗まれない。

これは、セキュリティ設計において非常に重要な考え方ではないだろうか。


最後に――個人情報保護法は誰のためにあるのか

個人情報保護法には、企業に個人情報を適切に管理させるための義務が定められている。

その意味で、法律が存在することには大きな意義がある。

しかし、これほど多くの情報流出が起きている現実を見れば、法律があるだけでは情報を守れないことも明らかだ。

だからこそ、私は次の点を改めて問い直したい。

企業が本当に必要かつ適切なセキュリティ対策を行っていたのか。

流出した情報は、具体的にどのような犯罪に利用できるのか。

金銭的な二次被害が発生していなくても、利用者の権利はどこまで守られるのか。

そして、企業は何百万件もの情報を保有する必要があるのか。

これらの問題を議論することなく、単に「情報流出しました」「二次被害は確認されていません」「再発防止に努めます」という発表だけで終わってしまうのであれば、同じような事件が繰り返されるのではないだろうか。

私は、個人情報流出のニュースを過度に恐れる必要はないと思う。

しかし、正しく恐れる必要はある。

メールアドレスだけが漏れたのか、パスワードが漏れたのか、それとも本人確認書類や決済情報まで流出したのか。

重要なのは、その違いを正しく理解することだ。

そして、企業側には、流出件数の大きさだけでなく、何が漏れ、なぜ漏れ、それによって何が起き得るのかを、利用者に分かる形で説明してほしい。

個人情報保護とは、企業が法律に従っていることを示すためのものではなく、利用者の権利と生活を守るためのものであるはずだ。

その原点を、今こそ見直す必要があると感じている。


参考資料

法律・公的機関

主な企業発表・事故記録

本記事は2026年11月8日時点の公表資料・報道資料等に基づく。件数や調査状況は今後変更される可能性がある。掲載一覧は主要事案を対象としたもので、期間内の全事業者・全事故を網羅するものではない。
AIは学習したことを超えられるのか――相対性理論の再発見テストが示した現在地

少し前に以前の記事で、AIはできないことまで「できる」と言い張るため、最後は人が設計と検証をしなければならない、と書いた。

その根っこには、もっと単純な考えがある。現在の生成AIは、学習した情報やパターンを材料に答えを作る。だから、学習も観測もしていない世界の真実を、自力で保証付きに取り出せるわけではない。

最近、この点をかなり分かりやすく試した検証が報じられていた。テーマは「1900年以前の資料だけを与えた言語モデルは、アインシュタインの相対性理論を再発見できるのか」である。

1900年以前の知識だけで、相対性理論にたどり着けるのか

科学誌Natureは2026年9月、この種の検証を「Einstein test」として紹介している。独立研究者が、1900年以前に書かれたテキストに限定してモデルを学習させ、量子論や特殊相対性理論、一般相対性理論に相当する説明を作れるか試したものだ。

結果は、少なくとも「AIが自力でアインシュタイン級の発見を再現した」と言えるものではなかった。Natureの記事によれば、モデルは多くのケースで失敗し、ときには世界についての強い内部表現を持たないまま、もっともらしい単語を並べているように見えたという。

これは重要なテストだと思う。相対性理論は1905年以後の知識である。現代のAIに相対性理論を説明させても、それが理解や発見によるものなのか、膨大な学習データからの再構成なのかは区別しにくい。そこで学習資料の時代を切り、後世の答えが混じらないようにする。初めて「すでに正解を見ていたAI」と「未知の問題を解いたAI」を分けて確かめられる。

もちろん、この一件だけで「AIは絶対に新発見をできない」と証明されたわけではない。学習データから後世の記述を完全に取り除く難しさ、モデルの規模、与えた問題設定、外部ツールの有無など、検証には条件がある。実際、実験の公開者自身も、データへの後世の情報混入を避けるために、年による選別だけでなく、Einsteinやrelativityなどの語を含む文書を除外したと説明している。

「学習した以上のことはできない」は、少しだけ言い換えるべき

以前の自分の言い方を、より正確に直すならこうなる。

現在の生成AIは、学習済みの知識や規則の組み合わせを超えて、未知の世界について正しい答えを自力で保証することはできない。

AIは学習データにそのまま存在しない文章、コード、デザイン案を出せる。そこは「丸暗記しかできない」という意味ではない。既知の部品を組み合わせ、類似性を見つけ、候補を大量に出すことは非常に得意である。

しかし、それは「未知の事実を知っている」こととは別だ。米国国立標準技術研究所(NIST)は、生成AIが次の単語を予測する事前学習を基にしているため、もっともらしく、しかも自信ありげに誤った内容を出す「confabulation(作話)」が起き得ると整理している。知らないことを「知らない」と止まる仕組みではなく、文脈に続きそうな答えを生成する仕組みだからだ。

研究でも、学習時と異なる条件への一般化は弱点として繰り返し確認されている。Transformerを用いた検証では、学習した範囲内で正答しても、より長い未経験の問題では性能が大きく落ちた。別の基礎的な研究でも、モデルの能力は訓練分布への過度な適合によって、分布外ではうまく一般化しない可能性が指摘されている。

AIは発明の「代わり」ではなく、発明を速くする道具になる

これはAIを否定する話ではない。むしろ逆で、AIは人間の調査、設計、実験を圧倒的に速くできる。論文を横断して仮説の候補を出す。コードを書いてシミュレーションを回す。膨大な観測データから、人間が見逃していた規則性を拾う。ここには大きな価値がある。

ただし、候補を出すことと、それが現実に正しいと確かめることは違う。後者には、新しい観測、実験、反証、そして責任を持つ人間の判断が要る。AIに外部検索、計算機、実験装置をつなげればできる範囲は広がるが、その場合も新しい情報を得ているのは、AI単体の学習済みモデルではなく、道具と世界からのフィードバックを含んだ仕組み全体である。

相対性理論の再発見テストは、AIが便利かどうかを測るためのものではない。「それらしい答え」を出す能力と、「世界の新しい原理」を発見する能力は別物だと、きれいに可視化した点に意味がある。

AIに仕事を任せるほど、この区別は大事になる。AIが出した答えは、優秀な下書きや仮説として扱う。未知の部分ほど、根拠を確認し、実際に動かし、必要なら捨てる。その手間を省いてはいけない。

参考

約660万件の個人情報漏えい。タイムズカーの事件から考える、日本のITが抱える深刻な問題

見た目は最新でも、中身は20年前。AI時代になっても変われない日本企業

2026年9月、カーシェアリングサービス「タイムズカー」で大規模な個人情報漏えい事件が発生した。

運営元のパーク24が公表した情報によると、不正アクセスによって約660万件ものアカウント情報が第三者に取得されたという。

漏えいした情報には、氏名、住所、電話番号、メールアドレスだけでなく、運転免許証情報や本人確認書類の画像なども含まれていた。

クレジットカード情報の漏えいは確認されていないものの、非常に深刻な事件である。Park24

そして、この事件をきっかけに、IT技術者の間であることが話題になった。

タイムズカーのWebシステムに、約20年前の技術が使われている可能性が指摘されたのだ。

個人的には、この話を聞いて驚いたというよりも、「やはり日本の大規模システムには、こういう問題が残っているのか」と感じた。

もちろん、古い技術が使われていることと、今回の不正アクセスの原因は別問題だ。

しかし、これだけAIが進化した時代になっても、古いシステムを刷新できない日本企業の体質については、考える必要があると思う。

Webサイトには、利用者から見える部分と見えない部分がある

そもそもWebシステムは、大きく「フロントエンド」と「バックエンド」に分かれている。

フロントエンドとは、私たちが普段ブラウザで見ている画面のことだ。

例えば、ログイン画面、予約画面、ボタン、メニュー、画像などが該当する。

HTML、CSS、JavaScriptといった技術で構成されており、ブラウザに配信されたソースコードは誰でも確認できる。

一方、バックエンドは、その裏側で動作しているプログラムだ。

会員情報の管理、ログイン認証、予約処理、データベースへのアクセスなど、サービスの中核となる処理を担当している。

こちらは通常、利用者からソースコードを見ることができない。

普段からWebサイトの内部構造を気にしている人など、IT技術者でもなければほとんどいないだろう。

大半の人は、画面のデザインや操作性を見る程度だ。

だからこそ、仮にバックエンドが20年前に開発されたものであっても、フロントエンドだけを新しくすれば、利用者には最新のWebシステムに見えてしまう。

見た目が新しいことと、システムの中身が新しいことは、まったく別の話なのである。

タイムズカーで見つかった古いJavaフレームワークの痕跡

今回、タイムズカーのWebサイトについて、技術者から興味深い指摘があった。

公開されているHTMLの中に、次のようなJavaScriptの読み込み記述が残っていたという。

<script src="/view/teedaExtension/org/seasar/teeda/ajax/js/ajax.js?20201217"></script>

ここに登場する「Seasar」と「Teeda」は、かつて日本の業務システム開発で利用されていたJavaのフレームワークだ。

Seasar2は2000年代に普及した国産のオープンソースフレームワークで、2016年にサポートが終了している。

Teedaは、そのSeasar2を利用したWebアプリケーションフレームワークである。System Design Works

つまり、少なくとも公開されているWebページには、現在ではサポートされていない古い技術の痕跡が残っていたことになる。

ただし、この記述だけでバックエンド全体がSeasar2で動いていると断定することはできない。

また、今回の不正アクセスがSeasar2やTeedaの脆弱性によって発生したという証拠もない。

それでも、もし現在もサポート終了済みのフレームワークが本番システムの中核で使われているとしたら、セキュリティ面で大きな懸念がある。

なぜなら、サポートが終了したソフトウェアでは、新たな脆弱性が発見されても、公式の修正プログラムが提供されない可能性が高いからだ。

JavaのStrutsやSpringでも重大な脆弱性が発見されてきた

JavaによるWebシステム開発では、Seasar2以外にもさまざまなフレームワークが利用されてきた。

代表的なものが「Apache Struts」と「Spring Framework」だ。

これらは、Webシステムを効率的に開発するための仕組みを提供している。

ただし、どれほど広く使われているフレームワークであっても、セキュリティ上の問題が発見されることはある。

例えば、Apache Struts 2では2017年に「CVE-2017-5638」という重大な脆弱性が発見された。

特定の条件下で、外部から不正なリクエストを送ることにより、サーバー上で任意のコードを実行できてしまうというものだ。

また、Spring Frameworkでも2022年に「Spring4Shell」と呼ばれる脆弱性(CVE-2022-22965)が公表された。

こちらも特定の環境や構成において、リモートからコードを実行される危険性があった。

いずれも、攻撃者に悪用されれば、サーバーの乗っ取りや情報漏えいにつながりかねない重大な問題である。

もちろん、StrutsやSpringを使っているだけで危険というわけではない。

重要なのは、使用しているバージョンと、適切なセキュリティ対策が行われているかどうかだ。

新しい脆弱性が発見されれば、開発元から修正版が提供される。

しかし、古いシステムでは、その修正版を適用すること自体が難しい場合がある。

例えば、フレームワークを更新すると既存のプログラムが動かなくなる。

Javaのバージョンを上げる必要がある。

Javaを更新すると、今度は別のライブラリが対応していない。

このように、古いシステムほど依存関係が複雑になり、簡単には更新できなくなってしまう。

結果として、脆弱性が存在する可能性を認識しながらも、システムを変更できないという状況が生まれる。

セキュリティ上の問題が見つかっても、修正できない。これこそが古いシステムを維持し続ける大きなリスクなのだ。

なぜ古いシステムを使い続けるのか

では、なぜ企業は古いシステムを使い続けるのだろうか。

理由の一つは、システムを刷新するためのコストだ。

大規模なWebシステムでは、何十万行、場合によっては何百万行ものプログラムが存在する。

それらをすべて解析し、新しい環境に移行するには、膨大な費用と時間が必要になる。

さらに厄介なのが、長年の改修によって複雑化したプログラムだ。

当初の開発者はすでに退職し、設計資料も十分に残っていない。

なぜその処理が必要なのか、どの機能と関連しているのか、誰も正確に把握していない。

いわゆる「ブラックボックス化」である。

こうなると、システムを変更すること自体が大きなリスクになる。

結果として、企業は既存システムを延命させるという選択を取りやすくなる。

しかし、ここで考えてほしい。

その判断は、AIが登場する前の常識に基づいていないだろうか。

AIの登場によって、古いシステムの刷新は現実的になった

以前であれば、古いプログラムを解析するには、技術者が一つずつソースコードを読み解く必要があった。

しかし、現在は状況が大きく変わっている。

生成AIの進化によって、ソフトウェア開発の効率は飛躍的に向上した。

例えば、AIを使えば、次のような作業を支援できる。

  • 古いJavaプログラムの構造解析
  • StrutsやSeasar2から新しいフレームワークへの移行
  • 複雑なプログラムの処理内容の説明
  • 既存コードからの設計書の生成
  • セキュリティ上の問題点の洗い出し
  • 自動テストの作成
  • 新旧システムの動作比較

これらは、従来であれば多くの技術者が膨大な時間をかけて実施していた作業だ。

もちろん、AIがすべてを完璧に処理できるわけではない。

業務上の細かなルールや、特殊な例外処理などは、人間による確認が必要になる。

それでも、AIを使うことで、これまで費用や時間の問題から手を付けられなかったシステムの刷新が、現実的な選択肢になりつつある。

特に、古いプログラムの解析や、新しい言語・フレームワークへの移植といった作業は、AIの能力を活用しやすい分野だ。

ただし、セキュリティが重要なシステムでは、AIによるコード生成だけでなく、テストや第三者による検証も欠かせない。

重要なのは、AIにすべてを任せることではなく、AIによって人間の開発能力を大きく拡張することなのである。

日本はAI活用でも世界に遅れを取るのか

個人的に最も気になるのは、日本企業のAIに対する姿勢だ。

AIが登場しても、情報漏えいが心配、生成したコードが正しいか分からない、社内ルールが整っていないといった理由で、導入に慎重な企業は少なくない。

もちろん、企業がセキュリティや品質を重視するのは当然だ。

しかし、それを理由にAIの活用そのものを避けていては、何も変わらない。

例えば、機密性の高いプログラムであれば、外部にソースコードを送信しないローカル環境でAIを動かすという選択肢もある。

AIが生成したコードの品質が心配なら、人間がレビューし、自動テストで検証すればよい。

実際、従来のソフトウェア開発でも、人間が書いたコードが必ず正しいわけではない。

人間が作ったプログラムにもバグは存在するし、セキュリティ上の問題も発生する。

AIだけに完璧さを求めるのは、少し違うのではないだろうか。

むしろ重要なのは、AIをどのように使い、どのように品質を保証するかという仕組みを作ることだ。

世界中でAIを活用したソフトウェア開発が進む中、日本企業が従来の開発手法に固執していれば、開発速度やコスト面で競争力を失っていく可能性がある。

日本は平和ボケしているのだろうか

少し厳しい言い方になるが、こうした状況を見ると、日本は平和ボケしているのではないかと感じる。

今のシステムが動いているから問題ない。

大きな障害が発生していないから、わざわざ作り直す必要はない。

システム刷新にはお金がかかるから、もう少し先送りしよう。

そうした判断を繰り返しているうちに、技術はどんどん古くなっていく。

そして、いざ問題が発生したときには、システムの構造を理解できる技術者もいなければ、簡単に修正する方法もない。

今回のタイムズカーの事件について、古いフレームワークが直接の原因だったかどうかは、現時点では分からない。

しかし、もしサポートが終了した技術を使い続けていたのであれば、そのリスクをどのように管理していたのかは気になるところだ。

特に、数百万人もの個人情報を扱うシステムであれば、なおさらである。

企業にとって、システムを変更しないことは、一見すると安全な選択に見えるかもしれない。

しかし、変更しないことによって、セキュリティ上のリスクが積み重なっていく場合もある。

これまでの日本企業は、安定性や品質を重視することで、高い信頼を築いてきた。

それ自体は素晴らしいことだと思う。

ただ、その慎重さが、新しい技術を取り入れない理由になってしまっては本末転倒だ。

AIの進化によって、ソフトウェア開発の常識は大きく変わろうとしている。

今までのやり方が正しかったからといって、これからも正しいとは限らない。

最後に

タイムズカーの約660万件の個人情報漏えい事件は、単なる一企業のセキュリティ問題として片付けるべきではないと思う。

日本には、長年にわたって使われ続けているWebシステムが数多く存在する。

その中には、すでにサポートが終了したフレームワークやライブラリを使用しているものもあるだろう。

もちろん、古いシステムだからといって、必ずしも危険とは限らない。

適切な保守やセキュリティ対策が行われていれば、長期間にわたって安全に運用できる場合もある。

しかし、問題は、そうした対策が十分に行われているかどうかだ。

そして、今はAIという強力な技術がある。

これまで難しかった古いプログラムの解析やシステムの刷新も、AIを活用することで、以前より効率的に進められる可能性がある。

それなのに、従来のやり方を変えようとしないのであれば、非常にもったいない話だ。

20年前のプログラムを使っていることが問題なのではない。20年前の考え方のまま、システムを運用し続けることが問題なのだ。

そして、AIがこれだけ進化した今、その考え方を変える絶好の機会が訪れているのではないだろうか。


参考資料

AI競争の本当のボトルネックは何か

生成AIについて日本で語られるとき、「AGI(汎用人工知能)はいつ実現するのか」という話題をよく目にする。

もちろん、AIがどこまで人間の知的能力に近づくのかは重要なテーマだ。

しかし現在のAI産業を別の角度から見ると、それとは異なる、もっと現実的な問題が急速に大きくなっている。

それが、

誰がAIを開発するのか。
そして、そのAIを動かす膨大な電力をどう確保するのか。

という問題だ。

AI競争は、単純な「モデルの賢さ」の競争から、人材、半導体、データセンター、電力、発電設備まで含めた巨大なインフラ競争へ変わりつつある。

米国のAIを支えている人材は、必ずしも米国で育った人材ではない

AI研究の中心地といえば米国、特にシリコンバレーを思い浮かべる。

しかし、そこで研究している人材がどこで育成されたのかを見ると興味深い数字が出てくる。

Paulson InstituteのシンクタンクMacroPoloは、AI分野の主要国際会議NeurIPS 2022に採択された論文の著者を調査し、トップ層のAI研究者がどこで学部教育を受け、現在どこの国で働いているのかを分析している。

その結果、米国の研究機関・企業で働くトップ層AI研究者の38%が、中国の大学で学部教育を受けていた。

一方、米国の大学で学部教育を受けた研究者は37%だった。

つまり、米国の最先端AI研究を支えている人材を「学部教育を受けた国」で分類すると、中国で教育を受けた研究者の割合が米国自身をわずかに上回っている。

ここで注意したいのは、この38%を「米国のAI研究者の38%が中国人」と単純に読み替えてはいけないことだ。

MacroPoloが分類基準にしているのは国籍や民族ではなく、学部をどの国の大学で卒業したかである。対象も米国のすべてのAIエンジニアではなく、NeurIPS採択論文の著者をもとにしたトップ層AI研究者だ。

それでも、この数字は中国のAI人材育成力の大きさを示している。

世界全体を見ると、その傾向はさらに顕著だ。

MacroPoloによれば、世界のトップ層AI研究者のうち、中国の大学で学部教育を受けた研究者は、

2019年:29%
2022年:47%

まで増加した。

つまり世界のトップAI人材のおよそ半分を、中国の大学が育成している計算になる。

一方、その人材を研究機関や企業として引き付けているのは依然として米国だ。

この構造を見ると、現在の米国のAI競争力は、

「米国だけで優秀な人材を育てているから強い」のではなく、世界中で育成された優秀な人材を集めることができるから強い

という側面が見えてくる。

特に、中国で育成されたAI研究者を米国の大学院や企業が吸収してきたことは、現在のAI産業を理解するうえで重要なポイントだ。

「AGIはいつ来るのか」より現実的な問題

もう一つ、現在のAI産業を見るうえで重要になっているのが電力だ。

AGIがいつ実現するのかについては様々な予測がある。

しかし、仮に現在のAIモデルがこれ以上進化しなかったとしても、AIの利用量が増加するだけで膨大な計算資源が必要になる。

そして計算資源を増やすためには、

GPU
データセンター
送電設備
発電設備
そして電力

が必要になる。

ここにはソフトウェアだけでは解決できない物理的な制約がある。

米国のシンクタンクCSISは2025年の報告書で、米国のAI計算能力を拡大するうえで、電力供給が最も強く制約している要因だと分析している。

特にデータセンター業界では現在、

「speed-to-power」

という考え方が重要になっている。

これは「土地を取得してから、実際に十分な電力を供給してもらえるまでどれだけ時間がかかるか」という意味だ。

CSISによれば、世界最大級のデータセンター集積地である米国北バージニアでは、新しいデータセンターが電力供給を受けるまで最大7年待ちになるケースまで出ている。

そのためデータセンター事業者にとって、電力価格や土地価格よりも「どれだけ早く電力を確保できるか」が重要になっているという。

これは非常に象徴的だ。

AIという最先端のソフトウェア産業が、最終的には

「コンセントから十分な電気を供給できるか」

という極めて物理的な問題にぶつかっている。

2030年にはデータセンターだけで現在の日本一国分を超える電力

国際エネルギー機関(IEA)の最新見通しでは、世界のデータセンターによる電力消費は、

2025年:約485TWh
2030年:約950TWh

へ、わずか5年間でほぼ倍増すると予測されている。

950TWhという規模は、現在の日本一国の年間電力消費量をやや上回る。

さらにAIに特化したデータセンターの電力消費量は、この期間に約3倍になると予測されている。

米国ではさらに影響が大きい。

IEAによると、2030年までに増加する米国の電力需要のほぼ半分をデータセンターが占める見通しだ。

つまりAI産業が今後成長できるかどうかは、AIモデルのアルゴリズムだけでは決まらない。

どれだけGPUを購入できても、それを置くデータセンターと、それを24時間動かす電力がなければ計算能力を増やせない。

AIの競争は「知能」から「物理世界」へ広がっている

ここまでを見ると、現在のAI競争には二つの特徴が見えてくる。

一つは人材の国際化だ。

中国は世界最大級のAI人材育成国になっている一方、その一部が米国へ移動し、米国企業や研究機関のAI開発を支えている。

米国の強さは、自国の研究者だけではなく、世界の優秀な研究者を吸収できるエコシステムにもある。

もう一つはAI競争の物理化だ。

AIモデルそのものはソフトウェアだが、それを大規模に動かすには、

半導体工場
GPU
データセンター
土地
送電網
変圧器
発電所
電力

が必要になる。

そして現在、その中でも特に電力供給が大きな制約として浮上している。

そのため、「AGIはいつ実現するのか」という議論とは別に、AI産業の現場では、

「これ以上AIを増やしたとき、それを動かす電力を本当に用意できるのか」

という、より差し迫った問題に直面している。

AGIが5年後に来るのか、10年後なのか、それとも「AGI」という境界そのものが曖昧になっていくのかは分からない。

しかし一つ確かなことがある。

AIの利用量はすでに急速に増えており、それを支える計算設備と電力は現実に必要になる。

現在のAI競争を見るなら、

「どのAIが一番賢いか」だけを見ていては全体像を捉えられない。

誰が優秀な人材を集めるのか。

誰が半導体を確保するのか。

誰がデータセンターを建設できるのか。

そして、

誰が大量の電力を確保できるのか。

AI競争は、デジタル空間だけの競争から、現実世界の資源とインフラを奪い合う競争へと広がっている。

「中国AIはすごい」と思いかけた私が、考えを改めた理由

Claudeの蒸留と、あまりにも大きな自爆

正直に言うと、私は一時期、「やっぱり中国はすごいのではないか」と思いかけていた。

アメリカによる半導体規制があり、最先端GPUを自由に入手できない状況に置かれている。それにもかかわらず、DeepSeekやQwen、Kimiといった中国系のAIが次々に登場し、性能面でもClaudeやGPTに迫っているように見える。

「GPUを制限されても、ここまでのAIを作れるのか」

そう考えると、単純に技術力の高さを感じてしまう。

もちろん、実際には中国へのGPU輸出は全面的にゼロというわけではなく、対象となる高性能半導体に厳しい輸出管理やライセンス制限がかかっているという話だ。それでも、最先端の計算資源に大きな制約があることは間違いない。米商務省も、中国向けの先端半導体やAI学習用コンピューティング資源を規制してきた一方、2026年には一部製品について条件付きの個別審査も行っている。^1

そんな環境で、欧米の一流AIと同等に見えるモデルを作った。

これはかなり凄いことだと思っていた。

もちろん「蒸留」という手法を使った可能性はある。蒸留とは、より高性能なAIに大量の質問をして、その回答や推論の仕方を別のAIに学習させる方法だ。大きなモデルの能力を、より小さく安価なモデルに移す技術であり、蒸留そのものは違法でも悪質でもない。AI業界では普通に使われている技術だという。

しかし、問題はその規模とやり方だった。

2026年2月、Anthropicは、DeepSeek、Moonshot、MiniMaxの3社が、約2万4000の不正アカウントを使い、Claudeに対して合計1600万回以上のやり取りを行っていたと発表した。目的は、Claudeの推論能力やコーディング能力などを抽出し、自社モデルの改善に利用することだったという。^2

さらに9月には、米国のNSA、FBI、CISAが、中国系AI企業による大規模な蒸留活動について共同勧告を出した。そこでは、DeepSeek、Alibaba、Moonshot、MiniMax、StepFun、Z.aiなどが、2024年末以降、アメリカの先端AIモデルから能力を抽出していたと指摘されている。中国側はこの主張を否定し、「蒸留は多くのAI企業が行っている一般的な手法だ」と反論している。^3

ここまでは、まだ「中国企業がClaudeを研究材料にしていた」という話である。

それでも私は、「蒸留を使ったとしても、実際に使えるモデルに仕上げるには技術が必要なのではないか」と考えていた。

そこまでは、まだ理解できる。

蒸留したデータを整理し、必要な回答だけを選び、学習に使える形へ変換し、別のモデルを訓練する。さらに、計算資源の少なさを補うために、モデルの構造や学習方法を工夫する。

そこには、一定の技術力が必要だろう。

しかし、今回明らかになった内容を見て、私は別の意味で驚かされた。

なんと一部の中国AI企業は、自分たちのAIを使っていると思っていた顧客の質問を、裏側でClaudeへ転送していたというのだ。

Anthropicの報告によれば、MoonshotはKimiを使っているはずのユーザーの質問をClaudeに送り、Claudeの回答をKimiの回答として表示していた。DeepSeekについても、自社モデルを使っているユーザーの一部のリクエストをClaudeへ中継していたとされている。しかも、その過程で顧客の内部文書やソースコード、認証情報、監視映像などの機密データが外部のAIサービスへ送られていた可能性があるという。[^4]

これは、あまりにも大きな自爆ではないだろうか。

「中国AIはClaudeに追いついた」と思っていたら、実際にはClaudeを使って自社AIを鍛えていた。

それだけなら、まだ競争の一環と言えなくもない。

ところが、その自社AIを使っているユーザーのデータまで、裏側でClaudeに流していた。

つまり、ClaudeをコピーするためにClaudeを使い、そのうえ自分たちの顧客情報までClaude側に渡していたということである。

これは「中国AIがすごい」という話とは、かなり違う。

むしろ、技術競争に勝とうとするあまり、顧客の信頼、データの安全性、サービスの透明性を自分から投げ捨ててしまったように見える。

私はもともと、中国AIを使うことには抵抗があった。

性能が低いからではない。むしろ、性能が高かったとしても使いたくなかった。

入力した情報がどこへ送られるのか分からない。企業の内部情報や個人情報が、別の場所で学習に利用されるかもしれない。中国政府や関連企業との関係も不透明だ。

もちろん、アメリカ企業のAIなら絶対に安心というわけではない。欧米企業にも、データ利用やプライバシーをめぐる問題はある。

それでも今回の件は、単なるデータ保護の問題を超えている。

自分たちのサービスを使っているユーザーに対して、「あなたはいま自社AIを使っています」と見せながら、裏側では別会社のAIを使っていた。しかも、そのデータを自社モデルの学習にも利用していた可能性がある。

これが事実なら、問題はAIの性能ではない。

企業としての誠実さの問題である。

私は今回、「中国はやっぱりすごい」という感想を改めることになった。

正確に言えば、中国に技術力がないと思ったわけではない。限られた計算資源で効率的なモデルを作る能力や、製品化の速さには、確かに見るべきものがある。

ただし、それは「完全に独自の技術でアメリカのAIを追い抜いた」という話とは違う。

先端モデルの出力を大量に収集し、推論能力を抽出し、さらにユーザーに説明しないまま別のAIへリクエストを転送していた。

それを見てしまうと、「中国AIがすごい」というより、「そこまでして追いついたように見せていたのか」という印象になってしまう。

結局、今回のニュースで一番印象に残ったのは、中国AIがClaudeと同等だったことではない。

Claudeを利用してClaudeに近づこうとし、その過程で自国企業や自国ユーザーの情報まで外部へ流してしまったことだ。

これは、技術的なショートカットというより、信頼を犠牲にした近道である。

そして、その近道の先で、自分たちが何をしているのかを暴露されてしまった。

これを私は「中国品質」と呼びたくなる。

ただし、ここで言う中国品質とは、中国人全体の性質という意味ではない。規制や監督が不十分で、結果さえ出せば手段が問われにくく、顧客のデータや説明責任が後回しになる企業文化や制度のことである。

AIは、性能だけで評価するものではない。

どれだけ賢いか。

どれだけ安いか。

どれだけ速いか。

それだけではなく、どこで作られ、何を学習し、ユーザーのデータをどう扱い、運営企業がどれだけ正直なのかまで含めて評価すべきだ。

そう考えると、今回の件で分かったのは、中国AIがアメリカAIを完全に追い抜いたということではない。

むしろ、まだ追いついていないからこそ、Claudeを大量に使い、コピーし、最後には自分たちのサービス利用者まで巻き込んでしまったという現実である。

「中国はやっぱりすごい」と思いかけた自分が、今回のニュースで考えを改めた。

すごかったのは、中国AIの独自性ではない。

自分たちで自分たちの信用を壊してしまう、その規模の大きさだった。

参考:

法人向けの仕事探しを経て、ボット開発の原点に戻る

ここしばらく、自分の会社の売上につなげるために、法人向けの仕事を探していました。

法人向けの仕事を探して気づいたこと

一人社長、一人社員、一人開発者という立場で企業から仕事を受けようとすると、仕事の内容以前に、「この会社に任せて大丈夫なのか」という信頼の壁があることを感じます。

実際、企画ビズというサービスを利用していたときには、ある時間になると仕事の依頼が一斉に届きました。ただ、その仕事について打ち合わせをするためには、まず限られた枠に入らなければいけません。

その枠は一瞬で決まってしまいます。枠に入れなければ、打ち合わせすらできません。自動化などを使って枠を確保する方法も考えましたが、そこまでして打ち合わせに進めたとしても、一人会社であることを理由に足元を見られてしまう可能性があります。

「仕事をもらうために、ここまでしなければいけないのか」と思いました。

マーケティング契約でも感じた違和感

法人向けの仕事を探す過程では、マーケティング会社との契約でも疑問を感じる経験がありました。アイドマ・ホールディングスとの経験も含め、ここでは自分が実際に経験した範囲の話として書きます。

サングローブという会社とは、マーケティングによって自社サイトに見込み客を呼び込むという説明を受け、担当してくれた方の印象もよかったため契約しました。「これなら仕事につながるかもしれない」と思ったからです。

しかし、契約前には費用がほとんどかからないような説明に受け取っていた一方で、実際には「Easier(イージア)」というシステムでホームページを作り、そのページへのアクセスをGoogle広告で集める仕組みでした。

Google広告を出すには広告費が必要です。広告費がなくなると、追加でお金を振り込んでほしいと言われました。事前に受けた説明と、契約後に実際に必要になった費用との間に、かなり差があるように感じました。

さらに、広告を始めた後は、掲載した電話番号に無言電話や営業電話が非常に多くかかってくるようになりました。一方で、私のところでは、サービスを必要としているエンドユーザーからの電話や問い合わせメールは確認できませんでした。

広告の効果もこちらからは分かりにくく、何が起きているのか判断できないまま、費用だけが発生していく。その結果、「話が違う」と感じ、騙されたとしか思えないような気持ちになりました。現在は、そのシステムの利用を実質的に止めています。

一人会社では、法人の顧客を得ることが難しい

こうした経験を通じて、一人社長の会社に対して法人の顧客やユーザーをつけることは、思っていた以上に難しいのだと分かりました。

もちろん、すべての法人やサービスに当てはまる話ではありません。ただ、少なくとも今の自分の会社の規模では、法人向けの仕事を取るために多くの競争や営業活動を経ても、対等な立場で見てもらえるとは限らない。

「ここまでしないと仕事が取れないのか」と考えているうちに、法人向けの仕事を追いかけることに少し冷めてしまいました。いったん、法人向けの仕事を取ることは諦めようと思います。

ものづくりの原点に戻る

ただ、もともと自分は、仕事を取ってくることよりも、ものを作ることが主体の人間です。自分の会社の売上を上げたいという目的は変わりませんが、その方法を見直すことにしました。

無理に法人向けの仕事を追いかけるより、自分でアプリを作り、必要としている個人の方に直接届ける。そのほうが、自分には合っているのではないかと思うようになりました。

これが、今回の「原点回帰」です。

現在、対応できているアプリの数はかなり少なくなってしまっています。まずはそこを、もう一度少しずつ増やしていきたいと考えています。

また、WindowsとMacの両方に対応していることも、改めて自分たちの強みとして打ち出していきたいと思っています。

そのために重要になるのが、ブラウザを操作する機能です。最近のWebサービスはブラウザ上で動くものが多く、対応するには、できるだけ最新のChromeに近いブラウザ環境が必要になります。

技術的に難しい部分もありますが、AIの力も活用しながら、これまでC#でしか実現できなかった機能を、再びC++でも動かせるようにしていきたいと考えています。

今後の予定

まずは、次の順番で対応を進める予定です。

  1. チケットぴあとローチケの対応を更新する
  2. ローチケの発売開始とリストックを検知できるように修正する
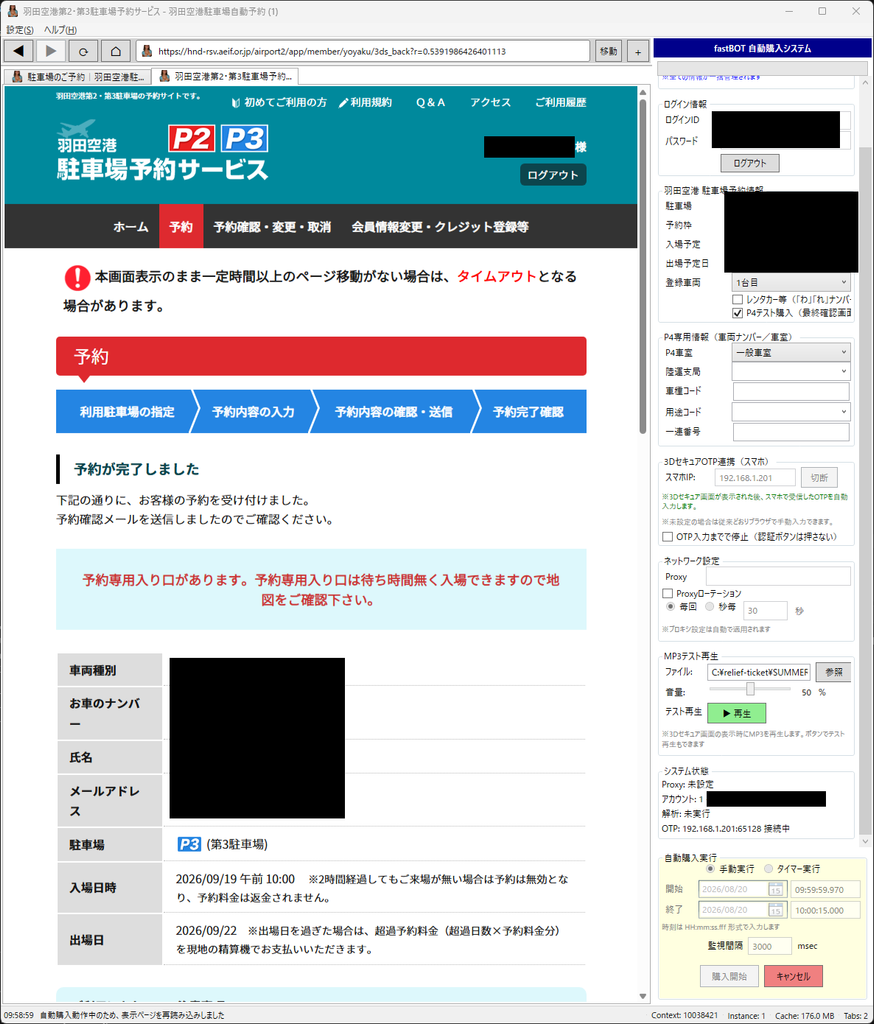
  3. 完成している羽田空港アプリをリリースする
  4. TIGET(チゲット)とLivePocketに順次対応する
  5. 今後要望があったサービスを、優先順位を考えながら追加していく

法人向けの仕事探しで遠回りしたからこそ、改めて自分は何をしたいのかが見えてきました。

自分で作り、必要としている人に届ける。これからは、ボットやアプリを作ることにもう一度集中していきたいと思います。

羽田空港P2・P3の激戦予約を自動化するツールを作りました

羽田空港を利用するとき、車で行きたい人にとって大きな問題になるのが駐車場の確保です。

特に羽田空港のP2・P3・P4駐車場は非常に人気が高く、

「30日前の予約開始時間に待機していたのに取れなかった」

という話が珍しくありません。

今回、この羽田空港P2・P3・P4の予約をできるだけ自動で行うためのツールを作成しました。

実際に動作させてみたところ、無事に駐車場予約を取得することができました。

羽田空港の駐車場予約は想像以上の激戦

羽田空港ではP2~P5の駐車場を事前予約できます。

P2・P3・P4については、基本的に利用日の30日前から予約できますが、予約開始時間が異なります。

  • P2:30日前の午前10時
  • P3:30日前の午前10時
  • P4:30日前の午前0時

P2・P3については公式予約サイトにも、

「入場日予定日の30日前の午前10時から予約できます」

と記載されています。P4については30日前の午前0時からです。

ところが問題は、

30日前になれば普通に予約できる、というものではない

ことです。

特に土日、3連休、ゴールデンウイーク、夏休み、お盆、年末年始などは予約が集中します。

実際、2026年に書かれた利用者ブログでも、

予約開始日に挑戦したものの「まさに、一瞬でした」と予約に失敗し、その後2週間サイトを確認し続けてようやく予約できた

という事例があります。

別の利用者も、P4を予約するために午前0時の予約開始に合わせ、

0:00ジャストに予約操作をしたにもかかわらず取れなかった

と書いています。

つまり、

「30日前になったから予約しよう」では遅く、30日前の予約開始時刻そのものが勝負

という世界です。

数秒~数十秒が勝負になる

現在では羽田空港駐車場の予約攻略を専門に扱うサイトまで存在しており、P2・P3について、

予約開始直後に予約枠が埋まる

という状況が紹介されています。

実際に「開始から1分も経っていないのに取れなかった」という利用者の例もあります。

予約開始時間になると、多くの利用者が一斉にアクセスします。

そのため、

  • 予約ページを開く
  • 利用日を選択する
  • 入庫時間を選択する
  • 出庫時間を選択する
  • 内容を確認する
  • クレジットカード決済へ進む
  • 必要なら本人認証を行う

と人間が操作している間にも、空いていた予約枠が他の人に取られてしまいます。

旅行の日程が決まっていて、

「飛行機は予約した」

「ホテルも予約した」

「レンタカーも予約した」

という状態なのに、

羽田空港まで車で行けるかどうかだけが30日前になるまで分からない

というのは、かなり不便です。

予約できなかったら当日早朝に行くしかない

もちろん、羽田空港の駐車場は予約スペースだけではありません。

予約が取れなくても一般駐車スペースに空きがあれば駐車できます。

しかし、こちらも確実ではありません。

羽田空港公式サイトでは、駐車場の混雑について、

「数時間待ちとなることが見受けられ、出発便の保安検査場締切時刻に間に合わない可能性がある」

と警告しています。

さらに金曜・土曜・日曜・祝日や多客期間については、

05:30~20:00を混雑時間帯

として案内しています。

つまり、予約が取れなかった場合、

「朝早く行けば何とかなるだろう」

という方法になりますが、それすら保証されません。

実際、夏休みに予約を取れなかった人が当日駐車を狙った例では、

朝5時30分頃に到着した時点ですでにP2の一部が満車、午前7時にはP3が満車

になっています。

飛行機の場合、

「駐車場が空くまで待つ」

という選択肢は現実的ではありません。

搭乗時刻があります。

子供を連れていたり、大きなスーツケースを持っていたりすると、離れた民間駐車場へ急きょ変更するのも大変です。

その意味でも、

羽田空港の駐車場を事前に確保できる安心感はかなり大きい

と思います。

P4はさらに競争が激しいと感じる

P2・P3とP4は、実は予約システム自体が異なります。

P2・P3の予約システムでは、クレジットカード決済時に、

本人認証サービス「3Dセキュア」がすべての予約で必須

になっています。

公式サイトにも、

すべての予約においてクレジットカード会社が提供する「本人認証サービス(3Dセキュア)」による認証を必須としております。

と明記されています。

一方、少なくとも今回私が確認したP4の予約フローでは、P2・P3のような3Dセキュア認証がありませんでした。

この違いは結構大きいです。

P4は、

予約 → クレジットカード決済 → 予約完了

までの手順が比較的短いため、予約開始直後の競争も非常に速くなります。

午前0時ジャストに操作しても予約できなかったという利用者がいるのも、その激しさを物語っています。

逆にP2・P3の場合は3Dセキュアという追加のハードルがあります。

そのため、

P4よりP2・P3の方が、3Dセキュア認証という敷居がある分、相対的には競争率が若干低いのではないか

と考えています。

ただし、羽田空港側から実際の予約倍率が公表されているわけではないため、これは予約システムと実際の操作感からの推測です。

いずれにしても、P2・P3も簡単に予約できるわけではありません。

そこで羽田空港駐車場予約ツールを作りました

毎回30日前の予約開始時間を覚えておき、

PCの前で待機して、

時間になった瞬間に画面を操作する。

しかもP4なら午前0時。

P2・P3なら午前10時なので、仕事をしている時間かもしれません。

これを毎回人間がやるのはかなり面倒です。

そこで、

羽田空港P2・P3・P4の予約操作を自動で行うツール

を作成しました。

実際に稼働させ、羽田空港駐車場の予約取得まで確認できています。

ツール側で予約開始時間に合わせて処理を行うため、人間が予約開始時刻にブラウザの前で待機して操作する必要がありません。

P2・P3で人間が行うのは基本的に3Dセキュアだけ

P2・P3の場合、公式側で3Dセキュアが必須になっています。

そのため通常構成では、

ツールが予約処理を進め、3Dセキュア認証が表示されたところだけ利用者が認証する

という形になります。

つまり人間が行うのは基本的に、

3Dセキュア認証の入力だけ

です。

予約開始10時ジャストにブラウザを開き、

利用日を選び、

時間を選び、

何度もボタンを押して……

という操作をする必要はありません。

Androidアプリと連携すれば3Dセキュアの入力も自動化

さらにAndroidアプリと連携させることで、

3Dセキュアの認証入力についても自動で処理できるようにしました。

そのためAndroid連携を使用する構成では、

予約開始から予約完了まで、ほぼ操作なし

で進められます。

P2・P3では3Dセキュアがあるため完全自動化が難しいと思っていましたが、Android側と連携することで、この部分まで処理できるようになりました。

【重要】初回だけWindowsファイアウォールの設定が必要

P2・P3で3Dセキュアを使用する場合、1点だけ事前に設定しておく必要があります。

ツール内部ではCefSharpを使用しています。

そのためWindowsの環境によっては、3Dセキュア処理を行っているタイミングで、

Windows Defender ファイアウォールの通信許可ダイアログ

が表示されることがあります。

ここでダイアログが表示されると自動処理が停止してしまいます。

環境によっては管理者権限の確認、いわゆるUACも絡むため、予約本番前に必ず設定しておく必要があります。

設定は一度行えば大丈夫です。

管理者権限でPowerShellを起動

WindowsのPowerShellを**「管理者として実行」**してください。

その後、以下を実行します。

$program = 'C:\haneda\runtimes\win-x64\native\cefsharp.browserSubprocess.exe'

New-NetFirewallRule `
  -DisplayName 'CefSharp.BrowserSubprocess TCP' `
  -Direction Inbound `
  -Program $program `
  -Protocol TCP `
  -Action Allow `
  -Profile Private,Public

New-NetFirewallRule `
  -DisplayName 'CefSharp.BrowserSubprocess UDP' `
  -Direction Inbound `
  -Program $program `
  -Protocol UDP `
  -Action Allow `
  -Profile Private,Public

これでCefSharp.BrowserSubprocessに対してTCP・UDPの通信許可ルールが追加されます。

設定できたか確認する

続けて以下を実行します。

Get-NetFirewallRule -DisplayName 'CefSharp.BrowserSubprocess TCP','CefSharp.BrowserSubprocess UDP'

2つのルールが表示され、

Enabled : True

となっていれば設定完了です。

この設定だけは、予約本番より前に必ず行ってください。

予約開始直後は数秒単位の争いになるため、そこでWindowsの確認ダイアログが表示されてしまうと、それだけで予約取得に失敗する可能性があります。

実際に予約を取得できました

今回、この仕組みを実際の羽田空港駐車場予約サイトで動作させ、

予約を取得できるところまで確認しました。

羽田空港の駐車場は、単に「予約サイトがあるから予約すればいい」というものではありません。

特に混雑する日は、

30日前の予約開始時間そのものが争奪戦

になっています。

予約に失敗すると、

  • キャンセルが出るまで何度も予約サイトを見る
  • 民間駐車場を探す
  • 電車やバスへ変更する
  • 当日かなり早い時間に羽田空港へ行く

といった対応が必要になります。

羽田空港公式自身も、混雑時には駐車場待ちが数時間に及ぶ場合があると案内しています。

そう考えると、

30日前の予約開始時間にPCの前で待つ必要がなく、自動で予約処理を行える

というだけでもかなり便利です。

さらにP2・P3については、

通常は3Dセキュアだけ手動

Androidアプリと連携すれば、

3Dセキュア部分まで含めて自動処理

できるようになっています。

羽田空港を車で頻繁に利用する人や、夏休み・ゴールデンウイーク・年末年始など、絶対に駐車場を確保しておきたい旅行では、かなり有効なツールになったと思います。

何より、

「30日前の予約開始時間にPCの前で待機して、数秒の争奪戦に参加する」

という作業から解放されるのが一番のメリットです。

同じメモリ(に見えた)を使って64GBから128GBにするのに苦労した話

結論

Ryzen 9 7950XとASRock B650 Steel Legend WiFiで、DDR5 32GBを4枚、合計128GB搭載したところ、起動時のメモリトレーニングでかなり苦労しました。

今回使ったメモリはCorsair VENGEANCE DDR5-5600です。

型番は4枚とも同じ、

CMK64GX5M2B5600Z40

です。

しかし、実際には64GB(32GB×2)のキットを2セット購入しており、メモリに記載されているVersionが異なっていました。

  • 2枚:Ver 3.34.02
  • 2枚:Ver 4.43.02

2枚構成なら、どちらのVersionでも問題なく起動します。

さらにVer 3とVer 4を1枚ずつ混在させても、A2/B2の2枚構成なら問題なく起動しました。

ところが4枚にすると状況が変わります。

メモリトレーニングが非常に長くなったり、DRAMランプが点滅したまま起動しなくなったりしました。

今回いろいろ試して分かったのは、

同じ型番のDDR5メモリでも、32GB×4の4 DIMM構成は、32GB×2とはまったく別物として考えた方がよい

ということです。


使用環境

今回の環境は以下です。

項目構成
CPUAMD Ryzen 9 7950X
マザーボードASRock B650 Steel Legend WiFi
BIOS4.43
メモリCorsair VENGEANCE DDR5
型番CMK64GX5M2B5600Z40
公称速度DDR5-5600
容量32GB×4 = 128GB
Ver3.34.02×2、4.43.02×2

最初はBIOS 3.01を使用していました。

メモリ関係の問題を疑い、最終的にはBIOS 4.43まで更新しています。


そもそもA1/A2/B1/B2とは何なのか

これも今回調べていて分かりにくかったところです。

B650 Steel Legend WiFiのDIMMスロットは、CPUに近い側から、

CPU
 |
 v

+-----------+    +----+ +----+ +----+ +----+
|           |    | A1 | | A2 | | B1 | | B2 |
| Ryzen 9   |    |    | |    | |    | |    |
| 7950X     |    |    | |    | |    | |    |
|           |    |    | |    | |    | |    |
+-----------+    +----+ +----+ +----+ +----+

という順番です。

ここで重要なのは、

  • A1/A2 = Channel A
  • B1/B2 = Channel B

という関係です。

論理的には、

                Ryzen 9 7950X
                      |
            +---------+---------+
            |                   |
        Channel A           Channel B
            |                   |
         +--+--+              +--+--+
         |     |              |     |
        A1    A2             B1    B2

となります。


なぜ2枚ならA2/B2なのか

ASRockのマニュアルを見ると、メモリを2枚だけ使用する場合はA2/B2に挿すよう指定されています。

最初は、

A1とA2があるのに、なぜ「1」ではなく「2」を優先するのか?

というのがよく分かりませんでした。

しかし、A/Bがメモリチャネルだと考えると理解しやすくなります。

A2/B2に1枚ずつ挿すと、

Channel A             Channel B
    |                     |
   A2                    B2
    |                     |
  32GB                  32GB

となり、CPUの2つのメモリチャネルを両方使用できます。

物理的には、

CPU側 →

A1     A2     B1     B2
[ ]    [RAM]  [ ]    [RAM]
        ↑             ↑

です。

このA2/B2が、各チャネル1枚で使用する場合の推奨スロットです。


2枚構成では問題がない

最初に各メモリキットを単独で試しました。

Ver 3.34.02を2枚、

A1     A2     B1     B2
[ ]    [V3]   [ ]    [V3]

として起動。

これは問題ありませんでした。

次にVer 4.43.02を2枚、

A1     A2     B1     B2
[ ]    [V4]   [ ]    [V4]

としても正常に起動しました。

つまり、どちらの64GBキットも単独では正常です。


Ver 3とVer 4を混ぜてみた

次に、

A1     A2     B1     B2
[ ]    [V4]   [ ]    [V3]

としてみました。

これも問題なく起動しました。

この結果はかなり重要でした。

少なくとも、

Ver 3とVer 4を混ぜた瞬間に起動できなくなる

というわけではありません。

A2/B2の2枚構成、つまり各チャネル1 DIMMであれば、異なるVersionを混在させても私の環境では正常に動作しました。


3枚にすると話が変わった

そこで3枚構成を試しました。

例えば、

A1     A2     B1     B2
[V3]   [V4]   [ ]    [V3]

です。

この構成ではうまく起動しませんでした。

DRAMのLEDが点滅し続け、メモリトレーニングから抜けられない状態になりました。

ところが別の配置、

A1     A2     B1     B2
[ ]    [V4]   [V3]   [V3]

では起動できました。

つまり単純に、

3枚だから絶対にダメ

というわけでもありません。

DIMMの配置によって結果が変わりました。


4枚ではメモリトレーニングが問題になる

最終的に使いたいのは、

A1     A2     B1     B2
[RAM]  [RAM]  [RAM]  [RAM]

という128GB構成です。

2枚の場合は、

Channel A : 1 DIMM
Channel B : 1 DIMM

なので1DPC(1 DIMM Per Channel)です。

一方4枚の場合は、

Channel A : A1 + A2
Channel B : B1 + B2

となり、2DPC(2 DIMMs Per Channel)になります。

同じ32GBのメモリを使っていても、CPUのメモリコントローラから見ると条件が大きく変わります。

今回の環境では、4 DIMMにするとメモリトレーニングが非常にシビアになりました。


DDR5-3600まで落としても解決しなかった

当然、DDR5-5600で4枚動かすのは厳しい可能性があるため、メモリクロックも落としました。

最終的にはDDR5-3600まで落として試しています。

しかし、

3600まで落とせば4枚でも簡単に安定する

という結果にはなりませんでした。

メモリトレーニング後に一度Windowsが起動することはあります。

問題は、その次の起動です。

再度メモリトレーニングが始まり、DRAM LEDが点滅したままになることがありました。

このため、単純なメモリクロックだけの問題ではないと判断しました。


Memory Context Restoreについて

AM5には、

Memory Context Restore

という設定があります。

これは、一度成功したメモリトレーニングの結果を次回の起動で再利用し、毎回フルのメモリトレーニングを行うことを避けるための機能です。

B650 Steel Legend WiFiのBIOS 4.43では、私の環境ではMemory Context RestoreはデフォルトでEnabledになっていました。

つまり今回、

MCRを有効にしていなかったから毎回トレーニングされていた

という単純な話ではありませんでした。

MCRがEnabledでも、4 DIMM構成ではトレーニング結果をうまく再利用できない場合がありました。


Power Down Enableも関係する

AM5のメモリ設定を調べていると、

Power Down Enable

という設定も出てきます。

これはDRAMの省電力機能ですが、Memory Context Restoreと組み合わせた際の挙動にも関係します。

今回、

Memory Context Restore = Enabled
Power Down Enable      = Enabled

という組み合わせも試しました。

ただし、MCRをEnabledにすれば必ず解決するというものではありませんでした。

128GBの4 DIMM構成そのものが正常にトレーニングでき、その結果を次回起動時に正常に復元できることが前提になります。


BIOSも3.01から4.43へ更新

最初に使用していたBIOSは3.01でした。

メモリ互換性やAGESAの更新もあるため、途中で最新の4.43へ更新しました。

BIOS更新後は、

  • EXPO
  • DRAM Frequency
  • Memory Context Restore
  • Power Down Enable
  • SoC Voltage
  • DRAM Voltage

などを一度Autoまたはデフォルトに戻し、そこから検証しています。

それでも2 DIMMと4 DIMMでは明確に挙動が違いました。


同じ型番でもVersionが違った

今回、もう一つ気になったのがCorsairメモリのVersionです。

4枚とも型番は、

CMK64GX5M2B5600Z40

で完全に同じです。

しかし実際には、

2枚:Ver 3.34.02
2枚:Ver 4.43.02

でした。

つまり、型番だけを見れば同じメモリですが、製造Versionは異なります。

ただし今回の検証では、

A1     A2     B1     B2
[ ]    [V4]   [ ]    [V3]

という異なるVersionを混在させた2枚構成でも正常に動作しました。

そのため、

Versionが違うから起動しない

と単純には結論付けられません。

むしろ、4 DIMMによって1チャネルあたり2枚になることの影響が大きいように見えます。


現在試している配置

3枚で、

CPU側 →

A1     A2     B1     B2
[ ]    [V4]   [V3]   [V3]

が正常に起動しました。

そこで現在は、

CPU側 →

A1     A2     B1     B2
[V4]   [V4]   [V3]   [V3]

という配置を試しています。

論理的には、

Channel A
 |
 +-- A1 : Ver 4.43.02
 +-- A2 : Ver 4.43.02


Channel B
 |
 +-- B1 : Ver 3.34.02
 +-- B2 : Ver 3.34.02

です。

各チャネルの中ではVersionを統一した形になります。

この配置で一度メモリトレーニングを正常に完走し、Windowsまで起動できれば、DIMMの位置を固定した上で、次回以降Memory Context Restoreが正常に機能するかを確認する予定です。


今回分かったこと

今回かなりの組み合わせを試しましたが、現時点では次のように考えています。

構成結果
Ver 3 ×2、A2/B2正常
Ver 4 ×2、A2/B2正常
Ver 3 + Ver 4、A2/B2正常
3 DIMM配置によって成功・失敗
4 DIMMトレーニングが非常にシビア
DDR5-36004 DIMM問題の完全な解決にはならず
BIOS 3.01使用当初の環境
BIOS 4.43更新後も検証継続
MCR Enabled4 DIMMで必ずトレーニングを回避できるわけではない

特に大きかったのは、

異なるVersionを2枚混ぜてもA2/B2なら正常に動く

という結果です。

これによって、単純なメモリVersion混在だけが原因とは考えにくくなりました。


最終的に64GB×2の方がよい可能性もある

今回の目的は128GB搭載することです。

その方法には、

32GB × 4 = 128GB

だけでなく、

64GB × 2 = 128GB

もあります。

AM5で128GBを安定して使用することを最優先するのであれば、64GB×2の方が合理的な可能性があります。

64GB×2なら、

A1     A2     B1     B2
[ ]    [64]   [ ]    [64]

となり、128GBでも1DPCを維持できます。

今回32GB×4で苦労している、

1チャネルにDIMMを2枚接続する

という条件そのものを避けられます。


最終判断

Ryzen 9 7950XでDDR5を128GB搭載する場合、

「DDR5-5600の32GBを4枚買って、速度を3600くらいまで落とせば普通に動くだろう」

と考えていました。

実際には、それほど単純ではありませんでした。

2枚ではまったく問題のないメモリでも、4枚にした途端にメモリトレーニングが非常にシビアになります。

さらに、

  • DIMMの配置
  • 1DPC / 2DPC
  • メモリのVersion
  • BIOS / AGESA
  • Memory Context Restore
  • Power Down Enable
  • メモリクロック

などが絡んできます。

少なくとも今回の検証では、異なるVersionの混在2枚構成は正常に動作しました。

したがって、現在最も疑っているのは、Versionの違いそのものではなく、

32GB×4による2DPC構成

です。

128GBが必要で、これから新しくメモリを購入するのであれば、32GB×4よりも64GB×2を選んだ方がトラブルは少ないと思います。

一方、手元に32GB×4があるので、もう少しこの構成で検証を続けます。

現在は、

A1     A2     B1     B2
[V4]   [V4]   [V3]   [V3]

という、各チャネル内でVersionを統一した配置を試しています。

この状態でMemory Context Restoreが正常に働き、毎回の長いメモリトレーニングを回避できるのか。

結果が分かったら追記します。

有効なはずのライセンスコードが未登録状態になる件について

表題の状態になるのは、当方の環境では起きることはありません。もしかすると、赤の他人に使われている可能性があるかもしれません。

こちらで再現できない以上、ユーザ側で起きることについてはこちらでは判断しようがありません。そのため、他の人に利用されている疑いがある場合は、ライセンスコードの再発行手続きを行ってください。こちらは有償対応となりますのでご了承ください。

サングローブと当社の相性

結論

サングローブ株式会社と「Easier(イージア)」は、実体のない業者ではありません。公式情報では、従業員1,766名、資本金8,500万円、東京・横浜・名古屋・大阪・福岡などに拠点を持ち、累計取引社数5万社を公表している、比較的大規模なWeb集客会社です。

ただし、Easierは「案件を紹介してくれるサービス」ではありません。

実態は、

LP・Webページを制作し、Web広告を運用して問い合わせを獲得する集客代行

です。発注ナビや比較ビズとは仕組みがまったく違います。

私の評価としては、その場で契約するのは避け、契約書と費用内訳を確認してから判断すべきサービスです。特に「中途解約不可」が大きな注意点です。


Easierの内容

公式説明では、次のサービスをまとめて提供します。

  • LP・集客ページ制作
  • Web広告の出稿・運用
  • ターゲット選定
  • 市場・競合分析
  • 広告データ分析
  • 専任担当者によるコンサルティング
  • LPや広告内容の改善

Easierの契約期間は、6か月・9か月・12か月で、最短でも6か月です。成果については「まず3~6か月で目に見える成果を目指す」と説明されています。

つまり、1か月試して成果がなければ止める、という契約ではありません。


最大の注意点:中途解約・返金が難しい

サングローブの「特定商取引法に基づく表記」には、次の趣旨が明記されています。

  • サイト制作開始後
  • サービス業務開始後

については、理由を問わず返金・中途解約を受け付けないとしています。また、顧客都合の解約も受け付けないとしています。

ここが一番重要です。

例えば12か月契約をして、2~3か月で、

  • 問い合わせがほとんど来ない
  • 問い合わせは来るが予算が低い
  • 開発案件ではなく営業電話ばかり
  • ターゲットがずれている
  • 担当者の対応に不満がある

という状態になっても、残期間分を止められない可能性があります。

法人間契約では、消費者向け通販のような感覚で簡単に解除できるとは限りません。申込書に押印する前に、解約条件を契約書本文で確認する必要があります。


料金が公開されていない

Easierの公式ページには、具体的な料金表が掲載されていません。

サングローブ側の表記も「各商品ごとに記載」となっており、実際には営業担当から見積書・申込書として提示される方式です。

確認すべきなのは、単なる月額料金ではなく、次の総額です。

  • LP制作費
  • 初期設定費
  • コンサルティング費
  • 広告運用手数料
  • Google・Metaなどへの実広告費
  • サーバー・ドメイン費
  • 写真撮影・ライティング費
  • 修正費
  • 契約期間全体の総支払額
  • 分割払いの場合の手数料
  • 契約満了後の月額費用

「月額○万円」と説明されても、広告費が別途なら総額は上がります。


営業電話についての評判

サングローブの公式番号として掲載されている「0120-225-173」について、匿名の電話番号口コミサイトには100件程度の投稿があります。

内容は一様ではなく、

  • 普通の市場調査・集客営業だった
  • 人当たりはよかった
  • 何を提案しているのか分かりにくかった
  • 人材紹介や集客の営業だった
  • 社長・役員に取り次ぐよう繰り返された
  • 就職希望者のような入り方だったと感じた

など、肯定・中立・否定が混在しています。

ただし、これは匿名掲示板です。

したがって、

  • 個々の投稿が事実とは確認できない
  • Easier契約者の口コミとは限らない
  • 他サービスの営業も同じ番号で行われている
  • 競合や無関係な人物の投稿も可能

という限界があります。

それでも、投稿数と内容から見ると、電話による新規開拓をかなり積極的に行っている会社であることは推測できます。サングローブの採用サイトも、営業部門や営業の再現性を重視する組織であることを前面に出しています。

「営業が強い会社」であることと、「契約後の集客成果が高いこと」は別問題です。


公式の「国内No.1」はどう見るべきか

Easierのページでは、

  • Web制作実績No.1
  • デジタル広告運用実績No.1
  • 調査機関:日本マーケティングリサーチ機構
  • 2025年11月期調査

と表示されています。

ただし、これはあくまで「実績数」に関するマーケティング表示です。

次の意味ではありません。

  • 契約企業の売上増加率No.1
  • 問い合わせ獲得率No.1
  • 顧客満足度No.1
  • システム開発会社向け集客No.1
  • 投資回収率No.1

また、調査対象企業、比較条件、集計方法などの詳細は、Easierのメインページからは十分確認できません。

したがって、No.1表示を理由に契約判断をするべきではありません。


掲載されている成功事例の注意点

Easierのページには、

  • ECサイトで売上4倍
  • 月間アクセス4倍以上
  • 月間アクセス10倍以上

などの事例があります。

ただし、公式にも、これらはEasier単独の事例ではなく、

サングローブがこれまで提供してきた各種サービスの体験談であり、Easierはそれらを集約したサービス

という説明があります。

つまり、

Easierを契約した企業が、全社同様に4倍・10倍になった

という統計ではありません。

また、アクセス数が増えても、受託開発会社では、

  • 問い合わせの予算が低い
  • 相見積もりだけ
  • 要件が固まっていない
  • 無料相談目的
  • 自社で対応できない分野
  • 営業・広告会社からの連絡

が増えるだけという可能性もあります。

アクセス数ではなく、受注金額と粗利益で判断する必要があります。


zatturight社との相性

一般的な「システム開発」広告は相性が悪い

「システム開発会社」「アプリ開発会社」という広い広告を出すと、競合が多くなります。

問い合わせも、

  • 予算50万円以下
  • アイデア段階
  • 見積もりだけ欲しい
  • 大人数体制を希望
  • 短納期
  • 保守要員を複数要求

となりやすく、1人開発体制とは合わない可能性があります。

比較ビズで感じた「人数・会社規模で判断される」問題は、広告集客でも完全には消えません。

専門分野を商品化すれば可能性はある

Easierを使うなら、会社全体を広告するのではなく、次のような専門サービスごとにLPを分ける必要があります。

  • 工場向けOPC UAアラーム通知システム
  • ESP32+クラウドのIoT試作開発
  • Twilioを使ったAI電話受付
  • 音声認識・音声合成システム
  • Qt/QMLによる業務用スマートフォンアプリ
  • WPF既存システム改修
  • Cloudflare Workers+WebSocket開発

例えば、

「システム開発を承ります」

ではなく、

「既存設備のOPC UAアラームを、電話・SMS・スマートフォンへ通知します」

くらいまで具体化する必要があります。

この方が、人数ではなく専門性で比較してもらえます。


契約前に必ず質問すべきこと

営業担当に口頭ではなく、メールか契約書で回答してもらうべき内容です。

費用

  1. 6か月・9か月・12か月それぞれの総額
  2. 広告費が含まれるか
  3. 広告運用手数料の割合
  4. 初期制作費
  5. 分割手数料
  6. 契約終了後の維持費

成果

  1. システム開発会社での実績
  2. 1~3名規模の開発会社での実績
  3. 月間問い合わせ数の中央値
  4. 問い合わせから商談になる割合
  5. 商談から受注になる割合
  6. 1件の問い合わせ獲得単価
  7. 受注企業の平均受注金額

契約

  1. 成果ゼロでも全額支払いが必要か
  2. 中途解約できる条件
  3. 担当者変更は可能か
  4. 広告アカウントの所有者
  5. LPと原稿の著作権・所有権
  6. 契約終了後もLPを利用できるか
  7. ドメイン・解析データを引き継げるか

特に重要なのが、Google広告アカウントを誰が所有するかです。

サングローブ側アカウントで広告を出す契約の場合、終了後に、

  • キーワードデータ
  • コンバージョンデータ
  • 除外キーワード
  • 広告文の実績
  • リマーケティングデータ

を持ち出せない可能性があります。


私の評価

項目評価
会社の実体・規模問題なし
サービス内容一般的なLP+広告運用
料金の透明性低い
契約期間6~12か月
中途解約の柔軟性かなり低い
成果保証確認できない
営業電話の評判否定的な匿名投稿も多い
公式成功事例あるが選抜事例
一般的な受託開発広告との相性低め
専門サービス特化広告との相性条件次第
即決非推奨

最終判断

サングローブ自体を「詐欺会社」と判断できる根拠はありません。

一方、Easierは、

  • 料金非公開
  • 最短6か月
  • 中途解約・返金が原則不可
  • 広告成果は事業や市場に依存
  • 成功事例は平均値ではない
  • 営業手法への否定的な匿名口コミが存在する

というサービスです。

zatturight社の場合、営業から提案を受けただけの段階なら、まだ契約しない方がよいです。契約候補に残すとしても、「システム開発全般」ではなく、1つの専門サービスに絞り、6か月総額を1件の粗利益で回収できるかを計算してからです。

申込書・契約書・見積書が届いている場合は、特に契約期間、総額、中途解約、広告費、LPの所有権を見る必要があります。